
模块解析 —— 加速 JavaScript 系统
- 译文性能优化
📖 简明总结:无论你是在构建、测试还是进行 JavaScript 代码检查(linting),模块解析始终是所有操作的核心。尽管它在我们的工具链中占据核心地位,但过去很少有人专注于提升其速度。本文讨论的改进可以让相关工具的运行速度提高 高达 30%。
在本系列的第一部分我们找到了一系列加速 JavaScript 工具中各类库的方法。虽然这些底层优化确实显著缩短了整体构建时间,但我在思考在工具中是否还有一些更根本性的环节可以改进 —— 关于JavaScript 中更常见的任务,如打包、测试和代码检查。
于是在接下来的几天里,我收集了大约十几份来自我们行业中常用的任务和工具的 CPU 性能分析。经过一番检查,我发现了一个在每份分析中都会出现的重复模式,他对这些任务总时长的影响高达 30%。这一环节在我们的基础设施中极为关键且影响深远,值得单独写一篇博客来进行说明。
这个关键的环节就是模块解析。在我查看的所有性能追踪中,它所消耗的总时间甚至超过了源代码解析的时间。
捕获调用栈的开销
这一切的起因是我注意到那些性能追踪中,耗时最高的环节是 captureLargerStackTrace —— 这是一个 Node 的内部函数,用于将调用栈附加到 Error 对象上。鉴于这两个任务都成功完成,且没有抛出任何错误,这看起来有些不正常。
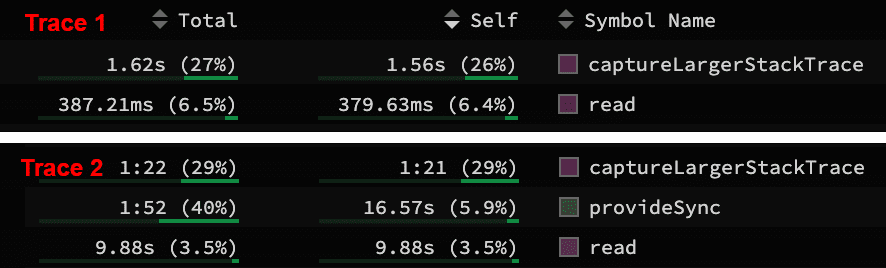
在浏览了性能分析中大量的调用记录后,一个更清晰的情况显现了出来。几乎所有的错误创建都由 fs.statSync() 调用,并且这个函数又是在另一个叫做 isFIle 的函数内部调用的。文档中提到 fs.statSync 基本相当于 POSIX 的 fstat 命令,用于检查磁盘上的路径是否存在,以及该路径是文件还是目录。基于这一点可得,我们只有在文件不存在或无权限访问等类似的情况下才会触发这个错误。所以是时候去看看 isFile 的源码了。
testjsx1function isFile(file) { 2 try { 3
乍一看,这个函数似乎人畜无害,但他却频繁出现在性能追踪中。值得注意的是,这里我们忽略了指定的错误并直接返回 false,而不是继续将错误抛出。无论是 ENOENT 还是 ENOTDIR 错误码,都表示路径在磁盘上不存在。或许我们看到的性能开销就是这里产生的?毕竟,这些错误被立马捕获并忽略了。为了验证这个猜想,我将所有 try/catch 代码块捕获的错误都记录了下来,结果不出所料:这里每个被抛出的错误,错误码不是 ENOENT 就是 ENOTDIR。
在查阅 node 中关于 fs.statSync 的文档后可以发现,它支持传入一个 throwIfNoEntry 选项,用于在文件系统中不存在对应文件时不要抛出错误。这种情况下他会返回 undefined 作为替代。
testjsx1function isFile(file) { 2 const stat = fs.statSync(
在使用这个参数后,我们可以去掉这个 catch 代码块中的 if 判断,因此这个 tyr/catch 也没有存在的意义了,这使得我们可以进一步简化这个函数。
仅这一项改动,就是我们的项目在代码检查阶段的耗时减少了 7%,令人惊喜的是,在测试阶段也同样因为这个改动而得到了近似程度的提升。
文件系统的高额性能开销
在消除了性能追踪中关于函数的性能开销后,我仍觉得问题仍未止步于此。毕竟,在一段持续几分钟的性能追踪中,抛出几个错误不应该会造成如此明显的影响。于是,我在这个函数中添加了一个计数器,来查看它的调用频率。结果很明显,他被调用了近一万五千次,差不多是这个项目中文件数量的十倍。看起来这里有着很大的优化空间。
模块化还是不模块化,这是个问题
默认情况下,一个工具要识别三种模块说明符(specifiers)
- 相对路径模块导入:
./foo,../bar/boof - 绝对路径模块导入:
/foo,/foo/bar/bob - 包导入:
foo,@foo/bar
从性能的角度来看,最值得关注的是第三种。这种即不由点 . 或斜杠 / 开头的直接导入的标识符,是基本只用于导入 npm 包的特殊导入方式。这种解析算饭在 node 的文档中有详细的说明。简单来说,他会尝试解析包名,然后会沿着文件目录向上遍历,查找是否存在包含该模块的特殊
node_modules 目录。让我们通过示例来说明这一过程。
假设我们有一个文件位于 /Users/marvinh/my-project/src/features/DetailPage/components/Layout/index.js,她想要导入一个模块 foo .那么模块解析算法会依次检查一下位置。
/Users/marvinh/my-project/src/features/DetailPage/components/Layout/node_modules/foo//Users/marvinh/my-project/src/features/DetailPage/components/node_modules/foo//Users/marvinh/my-project/src/features/DetailPage/node_modules/foo//Users/marvinh/my-project/src/features/node_modules/foo//Users/marvinh/my-project/src/node_modules/foo//Users/marvinh/my-project/node_modules/foo//Users/marvinh/node_modules/foo//Users/node_modules/foo/
这意味着需要进行大量的文件系统调用。简而言之,在解析过程中的每层目录都会检查是否存在模块目录,这意味着检查次数和文件所在的目录层级数量直接相关。问题在于,这会在每一个导入了 foo 模块的文件中重复进行。如果有另一个在不同位置的文件同样导入了 foo 模块,那么解析器将同样沿着整个目录树向上遍历,直到找到包含模块的 node_modules 目录为止。因此,对已解析过的模块进行缓存将会带来显著的性能提升。
而情况更有趣的是,许多项目会使用路径映射别名来减少输入量,从而在整个项目中统一使用导入说明符,避免出现大量 ../../../。这种做法通常通过 TypeScript 的 paths 编译选项或打包工具中的 resolve alias 来实现。但问题在于,这些别名通常很难与包导入区分开来。例如,如果我为位于 /Users/marvinh/my-project/src/features/ 的 features 目录添加了路径映射,我就可以使用 import {...} from "features/DetailPage" 这个声明来导入他,同样,每个工具都可以识别这个别名。
但是如果工具不支持呢?由于没有一个统一的模块解析包被所有的 JavaScript 工具所使用,所以目前有多个各自独立的解析实现,他们对此功能的支持程度也各不相同。在我的案例中,项目中使用了大量的路径映射,同时包含了一个不识别 typescript tsconfig.json 中路径映射代码的代码检查插件。那么自然这个插件就会将 feature/DetailPage 看做是一个 node 模块,并通过向上遍历的方式来寻找这个模块,结果没有找到,并抛出了错误。
对所有内容进行缓存
接下来,我改进了日志记录,来查看该函数被调用时使用了多少不同的文件路径,以及是否返回了相同的结果。记过显示只有约 2.5k 次对 isFile 的调用使用了唯一的路径,并且传入的文件参数和返回结果基本呈现出一一对应的关系。虽然这一数量仍然超过了项目文件数量,但远低于之前的一万五千次调用总数。那么,如果我们在函数外层添加一个缓存来避免每次都访问文件系统,结果会如何呢?
testjsx1const cache = new Map(); 2 3
引入缓存后,代码检查的耗时又加快了 15%。真不错!不过缓存的风险在于他可能会过期,所以有必要在某个时刻对缓存进行失效处理。为了保险起见,我最终选择了一种更稳妥的方式:在使用缓存前,先检查文件是否仍然存在。考虑到工具总是在 watch 模式下运行,所以这种方法并不罕见 —— 这种模式下,工具通常会缓存所有数据,并只对已修改的文件进行失效处理。
testjsx1const cache = new Map(); 2
老实说,当我将之前的逻辑调整为即使命中了缓存,也访问文件系统进行检查之后,我以为他会抵消添加缓存后带来的性能提升。但当我观察了记录的次数后,我发现他对于之前的提升只影响了 0.05%. 这几乎可以忽略不计了,但是额外的文件系统调用不应该产生更大的影响吗?
文件扩展名的”猜谜游戏”
JavaScript 模块的问题在于,这门语言一开始并没有内置模块系统。当 node.js 出现了,他推广了 CommonJS 模块系统。这个系统有几个“有趣”的特性,例如可以省略被加载文件的扩展名。例如当你类似 require("/foo)" 的语句时,他会自动添加上 .js 扩展名并尝试读取 ./foo.js 文件。如果文件不存在,他会接着检查 json 文件 ./foo.json ,如果他也不存在,则会检查 ./foo/index.js 。
这里其实主要处理的是歧义问题,工具必须准确判断 ./foo 应该解析的是哪个文件。因为无法事先确定文件在哪里,所以未导致大量的无用的文件系统调用。工具必须注意尝试每种可能的组合,直到找到匹配的为止。考虑到当前如今可能的扩展名的数量,这个问题就更严重了。工具通常要维护一个用于检查的所有潜在扩展名的数组。在包含 TypeScript 的前提下,一个传统前端项目可能包含的扩展名数组如下所示:
testjsx1const extensions = [ 2 ".js", 3 ".jsx",
这意味着工具需要检查八种潜在的扩展名。而且 这并不是全部,在考虑到可能使用同样扩展名的 index 文件,这个列表基本上要再翻一倍。这意味着我们的工具别无选择,只能循环遍历扩展名列表,直到我们找到磁盘上存在的文件。当我们尝试解析实际为 ./foo.ts 的 ./foo 文件时,我们需要检查:
foo.js-> doesn’t existfoo.jsx-> doesn’t existfoo.cjs-> doesn’t existfoo.mjs-> doesn’t existfoo.ts-> bingo!
这导致了四次不必要的文件系统调用。当然,你可以调整扩展名的顺序,把项目中最常用的扩展名放到数组的开头。这能提高尽早找到正确扩展名的概率,单着并不能完全解决问题。
在 ES2015 规范的中,提出了一个新的模块系统。尽管当时还没有完全确定所有的细节,但语法已经确定下来了。import 语句凭借着其在工具链方面比 CommonJS 有更多优势,很快便占据了主导地位。由于其静态特性,它为更多的工具改进功能提供的空间,其中最著名的就是 tree-shaking —— 可以轻松检测那些未被使用的模块,甚至是模块中未被使用的函数,从而优化生产环境构建。自然,所有人都开始使用新的 import 语法。
不过仍然有个问题:由于当时只有语法被确定下来,而实际的模块加载或解析方式并不明确。为了弥补这一空白,工具沿用了 CommonJS 现存的语义。这样对代码移植来说非常有利,因为大部分改动只需要进行语法上的改动,并且这些改动可以通过代码转换工具自动完成。从推广的角度来看,这无疑非常有效。但这意味着我们同样继承了之前的扩展名“猜谜游戏”。
关于模块导入和解析的细节在几年后最终被确定了下来,并通过强制制定扩展名的方式修复了这个问题。
testjsx1// Invalid ESM, missing extension in import specifier 2import { doSomething } from "./foo"; 3
通过消除这一歧义,并始终强制要求添加扩展名,我们避免了所有这类问题。工具的运行速度也提高了。但要让整个生态系统采纳这一做法仍需要一段时间,甚至不会完全实现。因为很多工具已经适应了这种歧义处理方式。
下一步该怎么做?
在整个调查过程中,我有些惊讶地发现,模块解析的优化空间竟然如此之大,尤其考虑到它在我们的工具链中占据如此核心的位置。本文中描述的几项改动就使代码检查耗时 降低了 30%!
我们这里所做的几项优化措施并非 JavaScript 所独有。在其他编程语言的工具链中同样可以找到类似的优化方法。在模块解析中,主要有四个要点:
- 尽量避免频繁访问文件系统
- 尽可能使用缓存,以减少对文件系统的调用
- 使用
fs.stat或fs.statSync时,务必设置throwIfNoEntry: false - 尽量限制向上遍历目录的次数
我们的工具链运行缓慢的问题并非由于 JavaScript 语言本身引起,而是因为相关环节没有得到完全的优化。由于没有一个统一的模块解析标准包,JavaScript 生态系统的碎片化也无法为帮助其改善这一点。正相反,存在了多个仅支持各自功能的子集。但这并不奇怪,因为多年来需要支持的功能列表不断增长,而且截至本文撰写之时,还没有任何一个库能够支持所有这些功能。如果有一个被所有人使用的统一库,就能让这一问题得到彻底解决,从而大大简化优化工作。