
一步一个库 —— 加速 JavaScript 系统
- 译文性能优化
📖 大多数主流的库都可以通过避免不必要的类型转换或者在函数中创建函数来提高性能。
第一部分:PostCSS, SVGO 等
尽管当前的主要趋势是用 Rust, Go 等其他语言来重写 JavaScript 的构建工具, 但目前的基于 JavaScript 的工具的性能仍然有很大的进步空间。在一个典型前端项目中,构建流水线通常由 许多不同的工具协同工作 组成。但是,工具的多样化使得工具维护者更加难以定位其中的性能瓶颈,因为他们必须清楚自己的工具会经常和哪些其他的工具组合使用。
尽管从纯语言性能的角度来看,JavaScript 确实不如 Rust 或 Go,但现有的 JavaScript 工具仍然有着相当大的优化空间。JavaScript 确实更慢一些,但不至于像现在这样与它们拉开如此大的差距。毕竟,如今的 JIT 引擎的性能已经很惊人了。
出于好奇,我花了些时间对一些常见的基于 JavaScript 的工具进行了性能分析,来大致看下其中的时间都消耗在哪里。首先从 PostCSS —— 一个非常流行的、几乎用于所有 CSS 相关处理的解析器和转换器说起。
在 PostCss 中节省 4.6 秒的性能开销
有一个非常有用的插件:postCss-custom-properties,它为旧版浏览器提供了对 CSS 自定义属性的基础支持。然而,在性能分析的调用轨迹中,它却异常显眼:仅它内部使用的一条正则表达式就消耗了高达 4.6 秒的时间。这看起来相当反常。
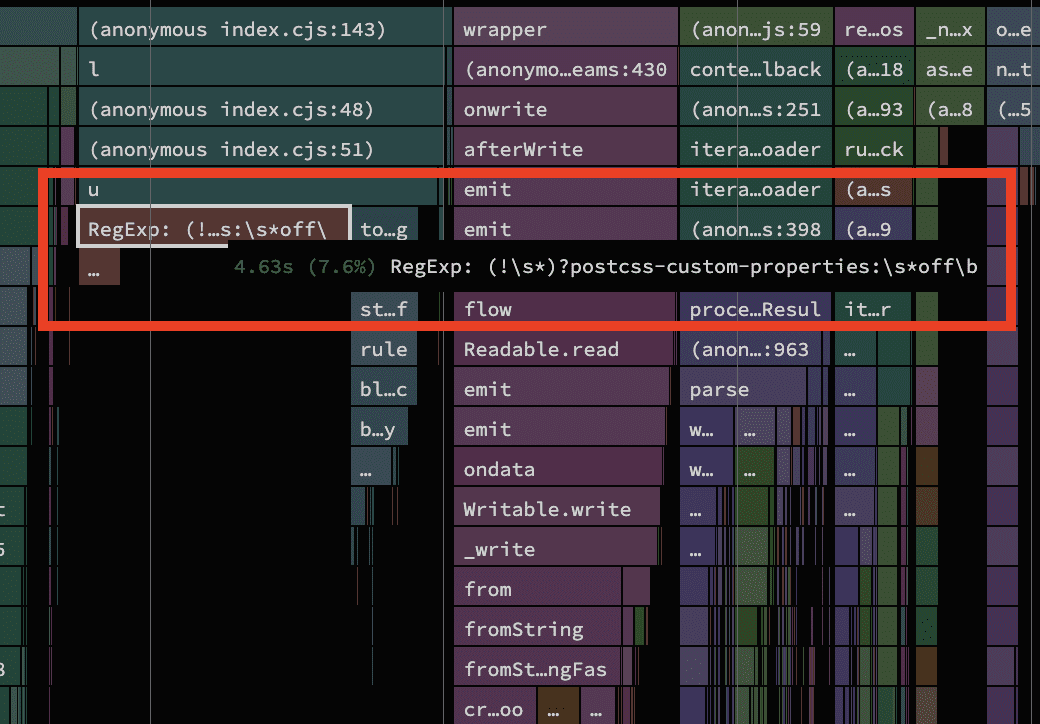
这条正则表达式看起来很可疑,它的作用似乎是在查找某个特定的注释内容,以改变插件的行为,这种用法和 eslint 用于禁用特定规则的注释上非常相似。虽然在他们的 README 中没有提及,但在查看源码后证实了这个推测。
testjsx1function isBlockIgnored(ruleOrDeclaration) { 2 const rule = ruleOrDeclaration.selector 3 ? ruleOrDeclaration 4 : ruleOrDeclaration.parent
rule.toString()引起了我的注意。在做性能优化是,凡是涉及类型转换的地方都值得重点关注,因为只要能避免类型转换,就几乎一定能节省时间。在这个场景中,有趣的地方在于 rule 变量始终是一个带有自定义 toString 方法的对象。他一开始就不是一个字符串,这意味着为了能让正则表达式正确匹配,我们不可避免的要付出一次序列化的性能成本。根据以往的经验我知道,对大量段字符串进行匹配,远比对少量长字符串进行匹配要慢的多。这正是一个非常典型、几乎在“等着被优化”的性能热点。
这段代码最令人担忧的点在于:无论输入文件中是否包含 PostCSS 注释,每个文件都必须为此付出这些性能开销。既然我们已经知道在长字符上进行正则匹配,要比在大量短字符反复运行正则匹配和序列化更高效。所以,如果能事先知道一个文件不包含任何 PostCSS 注释,就完全没有必要去调用 isBlockIgnored 这个函数。
在这一修复上线后,构建时间直接大幅缩短了 4.6 秒,相当惊人。
优化 SVG 压缩速度
接下来要看的是 SVGO,一个用于压缩 SVG 文件的库。他非常出色,几乎是大量使用 SVG 图标的项目的标配工具。不过,从 CPU 性能分析结果来看,仅 SVG 压缩这一过程就耗费了 3.1 秒。这个过程还能再加速吗?
在进一步审查性能分析数据时,一个函数格外显眼:strongRound。更值得注意的是,这个函数调用后面经常跟随着一次小规模的 GC 清理(见那些小小的红色方块标记)。
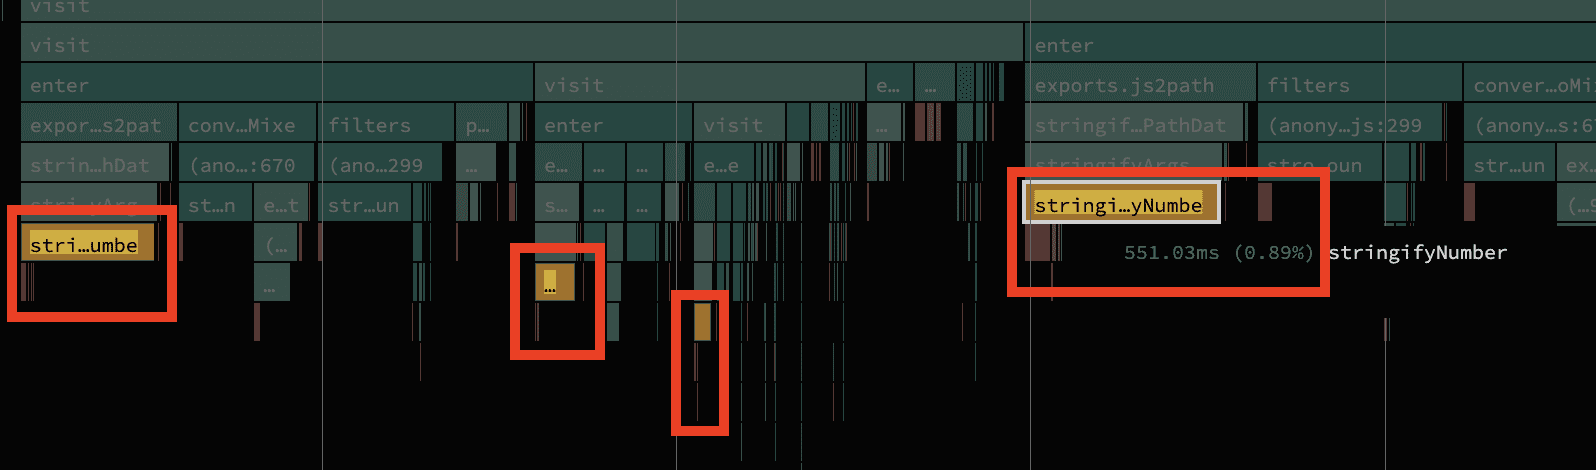
我的好奇心被激起来了,让我们直接在 GitHub 上看看它的源码。
testjsx1/** 2 * Decrease accuracy of floating-point numbers 3 * in path data keeping a specified number of decimals. 4 * Smart rounds values like 2.3491 to 2.35 instead of 2.349.
Aha!原来这是一个用于压缩数字的函数,而在任何典型的 SVG 文件中,数字的数量都很庞大。这个函数接受一个数字数组,且预期会直接修改数组中的元素。让我们关注下他的实现中所使用的变量类型。随着进一步观察可以发现,代码中存在着大量字符串和数字来回转换的情况。
testjsx1function strongRound(data: number[])
类似于给数字进行四舍五入这种事,本质上可以只通过数学运算来完成,没有必要把数字转换成字符串。一般来说,相当一部分性能优化的核心思想,就是尽可能用数值运算来表达问题,核心原因就在于:CPU 在数值运算方面的效率极高。通过对代码进行一些调整,我们就可以始终停留在”数字层面“来避免将其转换成字符串所带来的开销。
testjsx1// Does the same as `Number.prototype.toFixed` but without casting 2// the return value to a string.
再次运行性能分析后可以确认,构建时间缩短了约 1.4 秒!我已经为此提交了一个 PR。
短字符上的正则表达式(第二部分)
在 strongRound 附近还有一个函数看起来很可疑,它的执行时间接近整整一秒(0.9秒)
和 strongRound 类似,这个函数同样用于压缩数字,但额外做了一件事:当数字带有小数部分,且绝对值介于正负 1 之间,可以去掉前置的 0。如 0.5 被压缩成 .5,-0.2 被压缩成 -.2。尤其是最后一行看起来很有意思。
testjsx1const stringifyNumber = (number: number, precision: number)
这里的代码是将数字转换成字符串,然后对其进行正则匹配。这个由数字转换的字符串基本可以确定会是一个段字符串。同时我们知道一个数字不可能同时满足 n > 0 && n < 1 和n > -1 && n < 0 这两个条件,就算是 NaN 也做不到。由此我们可以推断出,每次只会有一个正则被匹配到,或者都不会被匹配到,但绝不可能两个都匹配。所以至少有一次 .replace 调用是在做无用功。
我们可以通过手动区分这些情况来进行优化。只有在明确知道数字存在前置 0 的情况下,才执行替换逻辑。这些数值判断要比执行正则搜索要快得多。
testjsx1const stringifyNumber = (number: number, precision: number
我们还可以更进一步,彻底移除正则匹配。因为我们 100% 确定前置 0 在字符串中的位置,因此完全可以直接对字符串进行裁剪,而非借助正则表达式。
testjsx1const stringifyNumber = (number: number, precision:
由于 SVGO 的代码中已经有一个专门用于去除前置 0 的方法,所以我们可以直接复用他。这样一来,又节省了 0.9 秒。Upstream PR.
内联函数,内敛缓存与递归
一个叫 monkey 的函数仅凭名字就引起了我的兴趣。从性能分析中我们可以看到它在自身内部被多次调用,这几乎就可以确定这里使用了某种递归,而递归经常被用在遍历树状结构中。
只要在代码中涉及到便利操作,他就很有可能处于代码中的”热点“路径上。虽然这不适用于所有场景,但根据我的经历来看,这是一条相当可靠的经验法则。
testjsx1function perItem(data, info, plugin, params, reverse
这段代码中,有一个函数在其自身创建了另一个函数,且这个函数会调用自身。如果让我猜的话,这样写大概率是为了少敲一段代码,为了避免在递归调用时反复传递所有参数。但问题在于,在函数内部动态创建的函数,当外层函数被频繁调用时,很难被引擎有效地优化。
testjsx1function perItem(items, info, plugin, params, reverse
我们可以通过显式传递所有参数,来彻底移除这个内部函数,而不是像之前那样通过闭包来捕获变量。这一改动的单项影响并不算大,但累计下来,也节省了约 0.8 秒的时间。
好在这一问题已经在最新的 3.0.0 主版本中得到了解决,只是整个生态迁移到新版本还需要一些时间。
警惕 for…of 的转移带来的开销
在 @vanilla-extract/css 中出现了一个几乎相同的问题, 在已发布的正式包中包含了下面这段代码。
testjsx1class ConditionalRuleset { 2 getSortedRuleset() { 3
这段函数有趣的地方在于,他并不存在于源代码中,在源代码中这里只是一个标准的 for…of 循环。
testjsx1class ConditionalRuleset { 2 getSortedRuleset() { 3
我没能在 babel 或 typescript的 repl 中复现这个问题,但可以确认的是,这确实是由他们的构建流水线引入的。鉴于这看起来是对他们构建工具的一层通用抽象,我猜测还会有不少其他项目受到同样的影响。因此我目前只是在 node_modules 中对此包进行了本地修复,令人满意的是,构建时间缩短了 0.9 秒。
semver 中的奇妙案例
关于这个问题,我不确实是不是我的配置有问题。但看上去每当 Babel 转译一个文件时,他都会重新读取完整 Babel 配置。
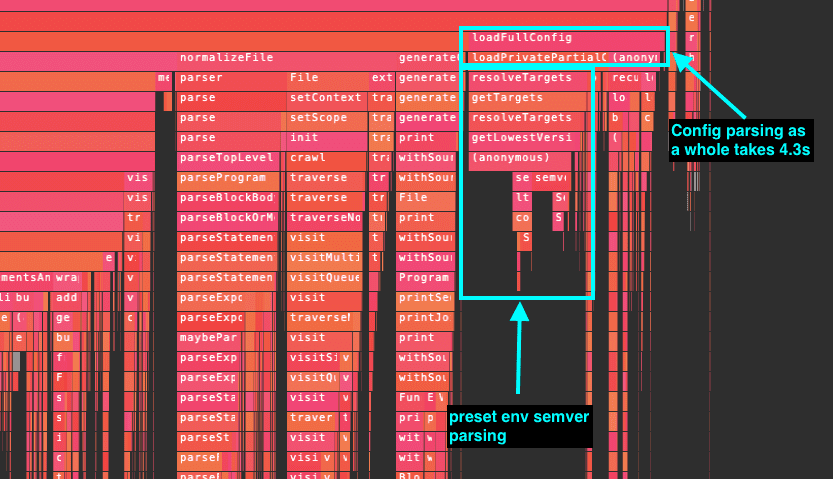
在截图中很难看清楚,但有一个占用时间相当多的函数,来自于 semver 这个包,也就是同样在 npm cli 中使用的那个 semver 包。这就有点令人迷惑了,semver 和 Babel 有什么关系?我过了好一会儿才恍然大悟:他是用来解析 @babel/preset-env 中的 Browserslist 目标配置的。尽管 Browserslist 的配置看起来只有短短一条,但当其展开后,最终会变成大约 290 个独立版本。
仅此一点还不是很让人担心,但是很容易让人忽略其使用各种校验函数时所带来的内存分配成本。这段流程在 babel 的代码中有些分散,但整体流程是将浏览器目标的版本号转换成 semver 字符串(例如将 10 转换为 10.0.0),然后进行校验。并且其中有些版本号是符合 semver 格式的。这些版本号,有时甚至是版本范围会彼此进行比较,直到找到我们所需要转译的最小公共特性集合。这种做法没有任何问题。
之所以这里会出现性能问题,是因为 semver 版本是以字符串形式存储的,而不是已经解析的 semver 数据类型。这意味着每次调用 semver.valid(’1.2.3’),都会新建一个 semver 实例且立即被销毁。同理当使用字符串进行 semver 版本号比较时:semver.lt(’1.2.3’,’9.8.7’)。这也是为什么在性能分析的调用轨迹中,semver 会如此显眼。
通过在本地的 node_modules 中进行修复,构建时间有进一步缩短了约 4.7 秒。
结论
到这里后我就没有在继续深挖了。不过我相信,在许多流行的库中可以找到更多类似的细微的性能问题。今天我们主要关注的是构建工具,不过在 UI 组件或其他类型的库中,通常也同样存在这种可快速发现的性能问题。
这些优化能让性能足以追上 Go 或 Rust 吗?基本上不行,但现有的 JavaScript 工具的性能确实可以比他们现在的表现更好更快。而本文所关注的内容,或多或少只是冰山一角。